第 5 篇把标注员点选记成同一会话下的真值,并约定候选卡上的命中图、通道名次与短原因。本篇是系列收束:怎么把这些记录当成评测 ground truth,怎样写「相对结论」而不把 POC 吹成生产 KPI,以及第一版刻意不做什么、在什么触发条件下才值得重新讨论。
场景仍与国内 top 纸企「纸品陈列审核 09 月批次」一致:约三百闭集候选、糊截图、复制检索键回 SaaS;第一篇界定问题形状,第二篇到第四篇分别讲建库对齐、多通道召回与加权融合。开放域 RAG 的评估与运营词汇可参考 企业级 RAG 怎么落地? 与 RAG 答非所问?从索引到生成——共享「混合检索、case 复盘、迭代」等概念,但闭集图检索的真值定义与成功标准不同,下文按闭集来写。
一、评测单元:确认会话 + 可回放的名次与融合
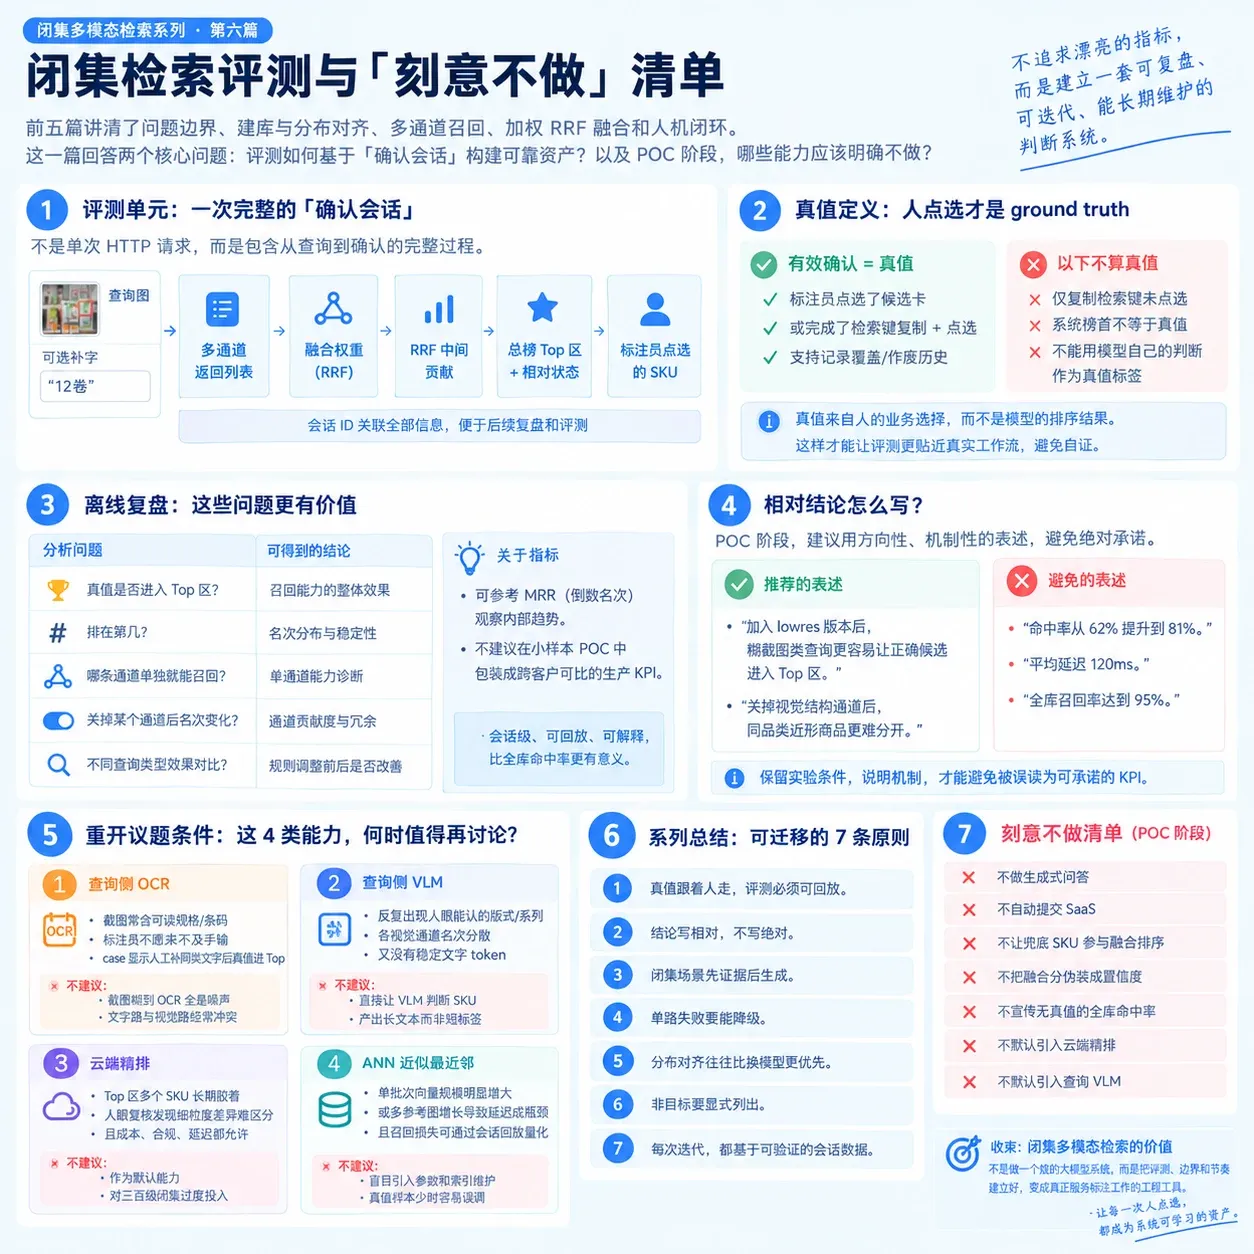
最小评测单元不是「一次 HTTP 请求」,而是 第 5 篇 里的一次确认会话:同一会话 id 下,查询图(及可选补字)、各通道有序列表、参与融合的权重与 RRF 中间结果、融合总榜 Top 区、相对状态文案,以及标注员最终点选的确认 SKU(真值)。
离线复盘时,系统应能按会话回放:
| 回放层 | 用途 |
|---|---|
| 查询快照 | 字节或 hash、是否带文字、批次 id |
| Per-channel ranks | 每个 SKU 在结构 / 语义 / 文字等路上的名次与命中哪张参考图 |
| 融合轨迹 | 哪些通道参与、权重、RRF 贡献(概念层即可,不必贴生产表名) |
| 展示态 | 候选卡顺序、弱匹配/候选接近等相对状态 |
| 真值 | 最后一次有效确认;覆盖或作废历史应可追踪 |
假数据 case(与系列前文 sku_101、sku_207 一致):标注员框选端架局部图并补「12 卷」,融合榜 #1 为 sku_101、#2 为 sku_207,人点选 sku_101 并复制检索键。评测问题可以是:真值在 Top 区第几名、哪条通道单独就把真值顶进 Top 区、关掉某通道后名次如何变——都是会话级、可对比的相对问题,而不是全库随机抽样的「命中率」。
真值来源:以人确认为准,不用融合榜首默认真值,也不把「复制了检索键但没点卡」算作真值标签。确认图回流索引后,应用同一会话的前后尝试或held-out 查询集看分布是否更贴,而不是混进未确认试搜的噪声。
二、相对结论怎么写:允许 vs 禁止
POC 阶段样本小、批次日更,对外和对自己都应避免绝对 KPI。推荐写可复现的相对表述;下列各举两条,写作时可直接当模板。
允许的表述(说明方向与机制,不绑具体数字):
- 「加入 lowres 版本后,糊截图类查询更容易让正确候选进入 Top 区」
- 「关掉视觉结构通道后,同品类近形商品更难分开」
禁止的表述(易被读成生产承诺或无法在本环境复现):
- 「命中率从 62% 提升到 81%」
- 「平均延迟 120ms」
还可用的相对维度:真值是否进入 Top-k(k 由产品定,如 Top5)、MRR 式的倒数名次(仅内部趋势)、某类查询(纯糊图 / 带规格字 / 近形竞品)上的前后对比、单通道 ablation 后「更容易/更难」——始终附带批次与规则版本,不写跨客户可比的绝对命中率。
三、何时再考虑:四条「触发条件」,不是路线图
第一版刻意保持本地、可降级、可回放。下面四条是议题重开条件;满足之前不必做,满足之后也仍是「值得试一次 ablation」,不是「一定要上生产」。
1. 查询侧 OCR
可考虑当:截图里经常包含可读规格/条码,但标注员不愿或来不及手输;且 case 显示「人工补同类文字后能进 Top 区、无字就掉出」。
仍可不做的理由:查询图糊到 OCR 全噪、或文字路与视觉路常冲突时,先调通道权重与参考图版本(第三篇)往往更便宜。
2. 查询侧 VLM(描述再搜)
可考虑当:反复出现「人一眼能认出版式/系列,但各视觉通道名次分散」的 case 簇,且没有稳定可用的文字 token;需要短标签进文字路或稀疏路由。
仍可不做的理由:闭集输出是 SKU 身份不是段落;VLM 幻觉规格会污染文字路。POC 优先 第二篇 的确认回流图对齐查询分布。
3. 云端精排(Cross-encoder / 大模型 rerank)
可考虑当:Top 区常有多 SKU 通道名次胶着(第四篇 的「候选接近」),且人眼复核显示细粒度包装差异仍难靠现有融合分开;云端调用成本、数据合规与端到端延迟预算允许做小批量 rerank 试验。
仍可不做的理由:闭集约三百候选,全量云端精排成本高、难回放;默认用加权 RRF + 人点选更贴合「缩小范围、人做终审」。
4. ANN / 近似最近邻
可考虑当:单批次向量规模明显超过当前 brute-force / pgvector 精确扫描配置的舒适区(例如闭集扩到数千 SKU、或多参考图乘积后延迟成为标注瓶颈),且召回损失可在会话回放里被量化到「真值名次系统性后移」。
仍可不做的理由:三百级闭集 POC 常是精确检索更简单;ANN 引入参数与评测复杂度,在真值样本少时容易误调。
四、可迁移原则(5–7 条)
- 真值跟着人走:确认会话是 ground truth;模型榜首只是假设,用于排序与解释,不替代人点选的真值。
- 评测可回放:保留 per-channel ranks 与融合输入,case 级 ablation 比全局一个分数更有用。
- 写相对不写绝对:趋势、Top 区、通道开关、批次版本——不写对外命中率与固定延迟。
- 闭集先证据后生成:输出是检索键与候选卡,不是生成式答案;与 企业级 RAG 的「拒答与引用」精神相通,形态不同。
- 单路失败可降级:某通道超时或空结果时其余路继续,总榜仍给有限候选(第三篇)。
- 分布对齐慢于换模型:确认回流图、lowres 参考等多图 max,往往比立刻上查询 VLM 更符合糊截图域差(第二篇)。
- 非目标显式列出:不自动写 SaaS、不替人关联、不把 POC 指标包装成 SLA——与下文清单一致,避免范围 creep。
五、刻意不做清单(与系列对齐)
| 非目标 | 说明 |
|---|---|
| 生成式问答 / 默认 RAG 聊天 | 见 第一篇 |
| 自动提交 SaaS 或改主数据 | 只复制检索键,人完成关联 |
| 兜底 SKU 参与融合排序 | 见 第五篇 |
| 用融合分当置信度对外承诺 | 见 第四篇 |
| 无真值的「全库命中率」宣传 | 本篇第二节 |
| 第一版就上云端全量精排 / 查询 VLM 默认开 | 第三节触发条件未满足则不做 |
六、系列收束
本系列从「为什么不是再做一个 RAG」走到「人点选的真值如何变成索引与评测资产」,中间贯穿建库对齐、多通道、加权融合与人机闭环。若你也在做小闭集、糊查询、人终审的多模态检索,最值得带走的是:会话级回放 + 相对结论 + 显式非目标,而不是某一组固定超参。
本系列
- 闭集多模态检索:为什么不是再做一个 RAG
- 多模态检索建库:分布对齐比换模型更重要
- 多通道召回:每种失败模式配一条检索路径
- 加权 RRF:多通道怎么融、弱匹配怎么降级
- 人机闭环:确认如何把检索变成可迭代资产
- 闭集检索评测与「刻意不做」清单
延伸阅读
- 企业级 RAG 怎么落地?不只是向量检索和大模型 —— 开放域知识问答的工程全景;评估与运营闭环的词汇可对照,问题形状不同。
- RAG 答非所问?从索引到生成,打通最后一公里 —— 索引、混合检索与生成侧优化;闭集场景通常停在检索与证据,不默认接生成。