上一篇把闭集多模态检索和开放域 RAG 拆开,并写清了第一版非目标:查询热路径上默认不做 VLM 读图、不做云端精排。标注员在「纸品陈列审核 09 月批次」里框出的目标,往往只有一百到两百像素宽;候选侧却是平台下发的清晰标准图。若建库只把标准图向量化就上线,后面换再大的视觉编码器,也常常是在错分布上较劲。
本篇只谈建库与分布对齐:索引里到底存什么、预处理怎么做、哪些昂贵步骤可以离线做。召回与融合在第 3、4 篇展开。
一、标准图与查询图:不是同一种「图」
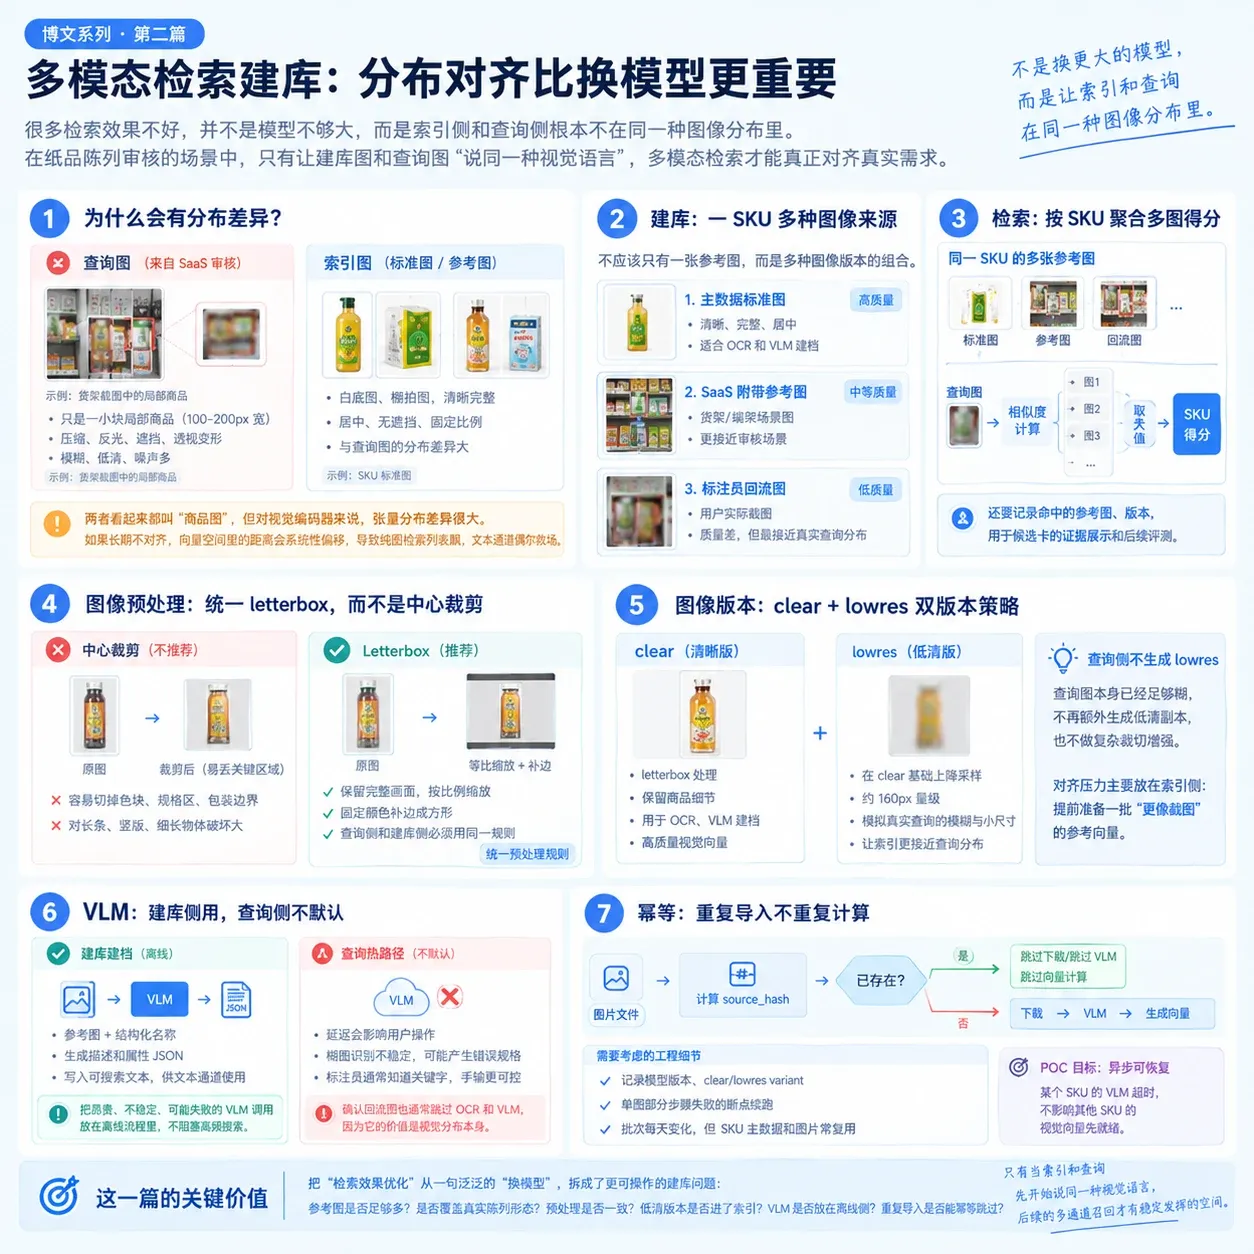
业务导入的 SKU 标准图,通常是白底或棚拍、分辨率够、包装完整。标注员粘贴的查询图,则是 SaaS 画面里的一小块:压缩、反光、遮挡、透视变形,像素总量可能只有标准图的十分之一。
视觉编码器学的是「整张图进网络前的张量分布」。查询与索引若长期处在不同尺度、不同清晰度、不同裁切策略下,向量空间里的距离会系统性偏移——表现为:文字通道偶尔救场,但纯图检索 Top 列表飘忽,且和人的肉眼判断对不上。
POC 里一个典型对比:同一批次里,sku_101 的标准主图很清晰,而查询侧是端架上一卷纸的局部;sku_207 规格文字在糊图里几乎不可读,但用户手输「12 卷」后文字通道能拉上来。这说明问题不总是「模型不够大」,而是索引侧有没有为糊查询准备可对齐的参考。
因此建库的第一原则:先让索引里有一部分向量和查询图处在相近分布,再讨论换 DINO、换 SigLIP 或加通道。
二、一个 SKU,多张参考图
闭集批次约三百个 SKU,但每个 SKU 在索引里不是「一张图一条向量」这么简单。实践中至少三类来源:
| 来源 | 含义 | 建库侧重 |
|---|---|---|
| 标准图 | 主数据 image 字段下发的商品图 | 清晰、完整,适合 OCR 与 VLM 建档 |
| SaaS 参考图 | 平台附带的 reference_images | 与标准图同等写入索引,常更接近审核画面 |
| 确认回流图 | 标注员确认后沉淀的查询截图 | 分布最接近真实查询,宜优先参与视觉召回 |
检索时按 SKU 聚合:同一 SKU 下多张参考图、多个版本各自算相似度,取最大值作为该 SKU 在该通道的得分,并记录「命中哪张参考图」——后面展示证据时要用。
确认回流如何进入库、如何和会话关联,属于人机闭环与数据飞轮,放在第 5 篇细讲。建库阶段只需记住:多参考图不是数据冗余,而是为分布对齐预留挂点;没有回流图时,更要靠预处理把标准图「降一档」。
三、letterbox:极端长宽比别中心裁剪
把任意比例图片送进方形输入,常见两种做法:中心裁剪,或 letterbox(等比缩放后补边成方形)。
层条、竖版海报、细长价签在纸品陈列里很常见。中心裁剪会切掉包装上的关键色块或规格区;对结构相似通道(偏形状与布局)尤其致命。POC 里统一采用 letterbox 补边:保留完整画面,空白边用固定色填充,查询侧与建库侧同一套规则。
查询路径同样 letterbox 后编码,避免「索引用裁切、查询用补边」这种隐蔽的不一致。用户已在 SaaS 外自行框选目标,系统不再做自动多主体检测——这和第一篇非目标一致。
四、clear + lowres:唯一保留的标准图增强
除 letterbox 外,我们对每张参考图生成两个视觉版本:
- clear:下载后的清晰版,经 letterbox,用于尽量保留商品细节;承担 OCR、VLM 建档,以及「高质量」视觉向量。
- lowres:在 clear 基础上降采样到约一百六十像素量级再 letterbox 回方形,刻意模拟查询截图的模糊与小尺寸。
两个版本分别算视觉向量(例如结构编码与跨模态编码各一套)。查询图本身已经够糊,不再在查询侧做 lowres 副本或多种裁切;对齐压力在索引侧。
这是 POC 里刻意收敛的增强:不做花哨的数据增广流水线,只做这一条「向查询分布靠拢」的腿。若 lowres 通道召回明显提升,而 clear 通道只在高清查询时有用,说明瓶颈在分布,而不是立刻换更大的 backbone。
五、VLM 只建档,不进查询热路径
清晰参考图上的文字、配色、版式,用本地 OCR 只能覆盖一部分;离线阶段可以用 VLM 根据「参考图 + 结构化名称」生成开放式描述与属性 JSON,写入可搜索文本,供后续文本语义通道使用。
这与第一篇非目标表直接对应:VLM 仅在建库异步任务中调用,失败可降级,不阻塞其他通道;查询时不默认把糊截图再送 VLM 转写——延迟、不稳定和噪声都会落在高频路径上。需要文字线索时,优先标注员在输入框补几个字。
云端调用内容限定为公开商品图与名称字段;密钥只放环境变量。建档结果要落库原始响应,便于日后换模型重算时对比,而不是只留一句摘要。
确认回流类参考图通常跳过 OCR 与 VLM:它们的价值在视觉分布本身,不必再让模型「描述一张本来就是为了检索而存的糊图」。
六、幂等:源内容哈希不变则跳过重算
批次一天一换,但 SKU 主数据常跨批次复用。重复导入同一参考图 URL、或中断后重启建库 worker,不应反复下载、反复调 VLM。做法是对图片字节内容算哈希,派生向量时记录 source_hash;哈希未变则跳过该图在该模型版本下的重算。
示意逻辑可以收成一行判断:
def should_recompute(source_hash: str, recorded_hash: str | None) -> bool:
return recorded_hash != source_hash工程上还要处理:模型升级(版本号变)、variant(clear / lowres)维度、单图部分步骤失败后的断点续跑。POC 阶段目标是 异步可恢复——某 SKU 的 VLM 超时,不影响同批次其他 SKU 的视觉向量先就绪,检索页显示建库覆盖率即可。
七、建库之后才是召回
分布对齐解决的是「索引和查询是否在说同一种视觉语言」。多参考图解决的是「同一 SKU 在陈列里长什么样都有样本」。在这一层打牢后,第 3 篇再谈多通道召回:结构、语义、文字匹配各守一条失败模式;第 4 篇谈加权 RRF 与弱匹配降级。
若你正在调效果,建议顺序是:先核对 letterbox 与 lowres 是否生效 → 再看多参考图覆盖率 → 最后才换编码器。这和闭集场景里「批次内三百候选、人要看见证据」的产品形状是一致的。
本系列
- 闭集多模态检索:为什么不是再做一个 RAG
- 多模态检索建库:分布对齐比换模型更重要
- 多通道召回:每种失败模式配一条检索路径
- 加权 RRF:多通道怎么融、弱匹配怎么降级
- 人机闭环:确认如何把检索变成可迭代资产
- 闭集检索评测与「刻意不做」清单