本文由项目沉淀整理而来,已去除具体单位、系统名称、内部链接和业务数据。文中的模型清单、数字和场景均做了抽象化处理,代码保留了核心逻辑。
RAG 回答清单类问题时漏项,往往不是检索错了,而是检索“对了一半”:同一篇文档被切成多片,单库 topK 只带回了前几片,剩下的条目根本没进上下文。模型只能基于看到的内容回答,于是给出一个看起来完整、实际缺了一半的清单。
我们的解法是在召回之后加一步“同文档切片补全”:当一篇小文档在同一个知识源里命中了多片,说明这个问题就是冲着这篇文档来的,那就把整篇文档的切片按原顺序全部补回来。改动不到一百行,不改索引、不调 topK,只对真正需要的文档生效。
一、一个真实的漏答案例
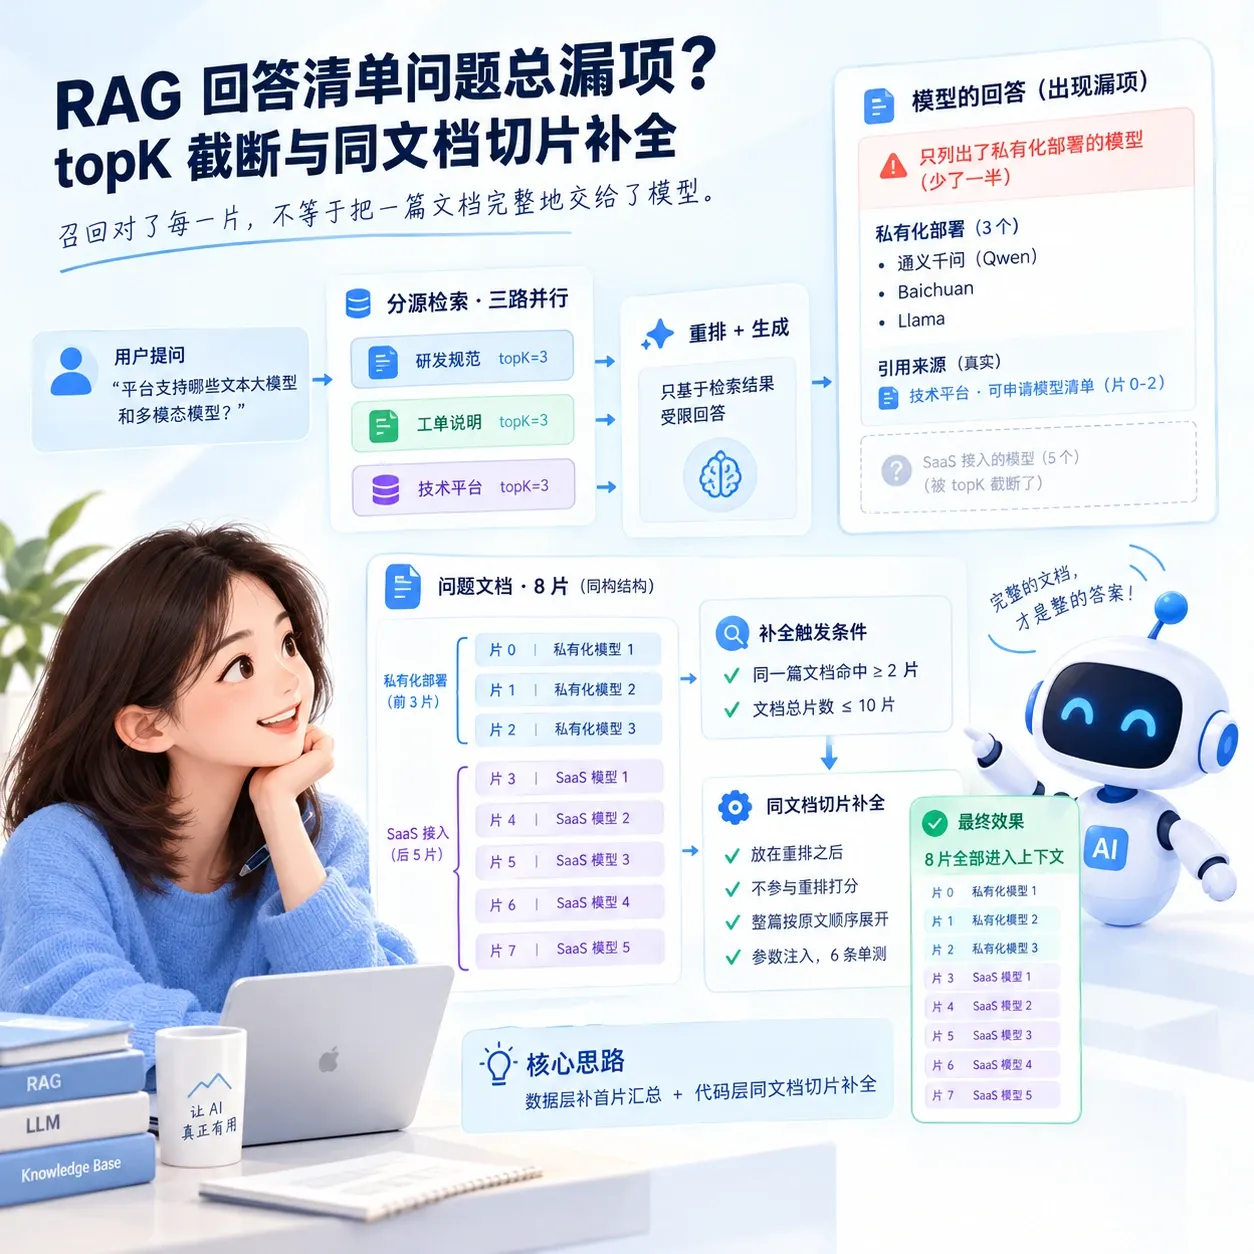
我们内部有一个技术服务助手,背后是一个分源的 RAG 知识库:研发规范、工单说明、技术平台三类资料各自建索引,提问时三路并行召回,每路取 topK=3,再交给大模型受限回答(只能用检索结果,不得补充外部知识)。
其中有一篇文档叫“AI 平台可申请模型清单”,内容大致是:
# AI 平台可申请模型清单
## 私有化部署 · 文本模型      ← chunk 0
## 私有化部署 · 多模态模型    ← chunk 1
## 私有化部署 · 向量/重排模型 ← chunk 2
## SaaS 接入 · 文本模型       ← chunk 3
## SaaS 接入 · 多模态模型     ← chunk 4
## 申请方式与注意事项         ← chunk 5 ~ 7
用户问:
平台支持哪些文本大模型和多模态模型?
助手回答得很流畅,列了一串私有化部署的模型,引用来源也正确。问题是 SaaS 接入的那一半完全没提。
排查召回日志后发现,检索本身没有任何问题:
- 技术平台这一路的 top3 全部来自这篇模型清单,命中的是 chunk 0、1、2;
- chunk 3、4 也和问题高度相关,只是排在第 4、5 名,被 topK=3 截掉了;
- 模型看不到 chunk 3、4,又被要求“只基于检索结果回答”,自然就只答了私有化部署。
这类问题最麻烦的地方在于:每一片召回都是对的,引用也是真的,答案读起来也完整,用户很难察觉漏了东西。
二、为什么清单类文档特别容易被截断
在流程类 RAG 漏步骤那篇里,我们讨论过“chunk 是局部的,流程是全局的”。清单类文档是同一个矛盾的另一种表现,而且更隐蔽。
清单类文档有几个特点:
- 各片之间相似度很接近。 文档里每一节都是同构的“类别 + 条目列表”,embedding 和关键词都很像,问题一来,往往会同时命中好几片,然后在 topK 边界上被随机截断。
- 用户问的是全集。 “支持哪些”“有哪些”“都包括什么”,问题本身要求的就是完整列表,缺一项就是错答。
- 模型无法感知缺失。 流程缺一步,模型有时还能从上下文里察觉“好像跳了一步”;清单缺一节,模型完全不知道后面还有内容。
- 文档通常不长。 一份清单切下来往往只有几片到十来片,完整放进上下文的成本并不高。
第 1 点和第 4 点放在一起,就引出了解法的核心判断:既然这类文档会同时命中多片,而且整篇也不大,那命中多片的时候,干脆把整篇给模型。
三、几种常见解法和它们的问题
在动手之前,我们把能想到的方案都过了一遍。
| 方案 | 做法 | 问题 |
|---|---|---|
| 调大 topK | 每路从 3 调到 8 或 10 | 全局生效,所有问题都多带噪声;三路并行时上下文成倍增长;清单再长一点还是会截断 |
| 首片放汇总 | 整理文档时在第一片写一份完整目录 | 有效,但依赖人工整理,每篇清单都要做,还要维护正文和汇总的一致性 |
| 文档摘要 | 召回时带上文档级 summary | 摘要是有损压缩,模型生成摘要时不会把几十个模型名都列出来 |
| 父子文档(small-to-big) | 小块建索引,命中后返回父块 | 需要改索引结构;父块怎么切又是一个新问题,切大了长文档会撑爆上下文 |
| 按文档召回 | 检索单位从 chunk 改成 document | 长文档的精准度会明显下降,等于放弃切片的好处 |
我们最后的做法是两层配合:
- 数据层:把这篇模型清单重新整理,在第一片放一份完整的模型汇总。这是立即见效的止血手段,但只能救这一篇。
- 代码层:在召回之后加一步通用的“同文档切片补全”,让所有满足条件的小文档都自动受益,不再依赖每篇都人工整理。
本文主要讲代码层。
四、核心判断:什么时候补全
补全不能无条件做,否则就退化成“按文档召回”了。我们用两个条件同时卡住:
同一文档在同一知识源的召回结果里命中 ≥ 2 片   → 说明问题聚焦在这篇文档
该文档总切片数 ≤ 10                          → 说明整篇放进上下文成本可控
两个条件同时满足 → 用整篇切片替换原来的零散命中
为什么是“命中 ≥ 2 片”而不是 1 片? 只命中 1 片,通常是问题恰好碰到了某篇文档的某个细节,比如问“某个 SaaS 模型怎么申请”,只需要那一片就够了。命中 2 片以上,才说明问题在“横扫”这篇文档,这正是清单类问题的典型信号。这个条件也让补全只在少数查询上触发,不会给每次召回都加一次数据库查询。
为什么要卡“总片数 ≤ 10”? 补全的前提是整篇放得下。一篇几十片的长规范命中了 2 片,把整篇塞进去只会稀释上下文,还可能挤掉其他知识源的结果。10 片是按我们的切片长度(单片 500 到 800 字)估出来的经验值,补全后单路最多 10 片,三路加起来仍在可接受范围内。
为什么在单个知识源内计数? 我们的三个知识源是独立 topK、独立排序的,RRF 分数跨源不可比。命中次数只在同一个源的结果里统计才有意义;不同源的候选文档最后合并去重,一次查询批量取回。这里有个前提:每篇文档只属于一个知识源。如果同一篇文档会被多个源收录,合并时要按源区分,否则在 A 源达标的文档会顺带在 B 源也被补全。
五、在检索链路里放在哪
整个召回链路是这样的:
用户问题
  → 意图识别
  → 问题只做一次 embedding
  → 三个知识源并行混合检索(向量 + 全文,RRF 融合),每源 topK
  → 按意图做规则重排
  → 同文档切片补全   ← 新增这一步
  → 按文档分组,带上文档摘要 / 完整步骤,组装 Prompt
  → 大模型受限回答
补全放在重排之后,有两个原因:
- 重排会改变各文档的先后顺序,补全应该基于最终顺序决定“整篇插在哪”;
- 补全出来的切片不参与重排打分,避免一篇文档因为片数多而在排序上占便宜。
接入代码只有几行:
export async function retrieveAllSources(input: {
  query: string;
  topK: number;
  intent: TechAssistantIntent;
}): Promise<SourceHit[]> {
  const sources = await retrieveKbSources({
    collectionCode: "tech-assistant",
    query: input.query,
    sourceTypes: TECH_SOURCES.map(source => source.sourceType),
    topK: input.topK,
  });
  const reranked = rerankTechAssistantSources(sources, input.intent);
  return expandSiblingChunks(reranked, documentIds =>
    fetchKbDocumentChunks(documentIds, SIBLING_EXPANSION_MAX_CHUNKS)
  );
}
expandSiblingChunks 接收一个取数函数,而不是直接依赖数据库。这样补全逻辑本身是纯函数式的,单测时传一个假的取数函数就行。
六、实现细节
1. 找出需要补全的文档
/** 同一文档在单库召回中至少命中几片才补全整篇 */
export const SIBLING_EXPANSION_MIN_HITS = 2;
/** 只补全切片数不超过该值的文档,避免长文档撑爆 prompt */
export const SIBLING_EXPANSION_MAX_CHUNKS = 10;

function documentsToExpand(results: KbSearchResult[]): string[] {
  const hits = new Map<string, number>();
  for (const r of results) {
    hits.set(r.documentId, (hits.get(r.documentId) ?? 0) + 1);
  }
  return [...hits]
    .filter(([, count]) => count >= SIBLING_EXPANSION_MIN_HITS)
    .map(([documentId]) => documentId);
}
这一步只做计数,不知道文档有多长。“长度是否超限”交给下一步的 SQL 判断。
2. 一条 SQL 批量取整篇,并在库里过滤长文档
SELECT chunk.id, chunk.document_id AS "documentId",
  doc.source_key AS "sourceKey", doc.title,
  doc.summary, doc.full_steps AS "fullSteps",
  chunk.chunk_index AS "chunkIndex", chunk.heading_path AS "headingPath",
  chunk.content_markdown AS "contentMarkdown", 0::float8 AS "rrfScore"
FROM kb_chunks AS chunk
JOIN kb_documents AS doc ON doc.id = chunk.document_id
WHERE chunk.document_id = ANY($1::text[])
  AND chunk.document_id IN (
    SELECT document_id FROM kb_chunks
    WHERE document_id = ANY($1::text[])
    GROUP BY document_id
    HAVING count(*) <= $2
  )
ORDER BY chunk.document_id, chunk.chunk_index
几个考虑:
- 所有知识源的候选文档合并成一次查询,补全最多只多一次数据库往返;
- 长度过滤用
HAVING count(*) <= $2放在库里做,超长文档的切片根本不会传回应用层; - 返回字段和正常召回结果的结构完全一致,下游的 Prompt 组装代码不用改;
- 文档级的
summary和full_steps一起带回,配合双层上下文的按文档分组逻辑,摘要只会输出一次。
3. 合并:插在首次命中的位置,按原文顺序展开
function mergeSource(
  results: KbSearchResult[],
  fullChunks: Map<string, KbSearchResult[]>
): KbSearchResult[] {
  const merged: KbSearchResult[] = [];
  const emitted = new Set<string>();
  for (const r of results) {
    const full = fullChunks.get(r.documentId);
    if (!full) {
      merged.push(r);
      continue;
    }
    if (emitted.has(r.documentId)) continue;
    emitted.add(r.documentId);

    const own = results.filter(h => h.documentId === r.documentId);
    const hitByIndex = new Map(own.map(h => [h.chunkIndex, h]));
    const floorScore = Math.min(...own.map(h => Number(h.rrfScore)));
    for (const c of [...full].sort((a, b) => a.chunkIndex - b.chunkIndex)) {
      merged.push(
        hitByIndex.get(c.chunkIndex) ?? { ...c, rrfScore: floorScore }
      );
    }
  }
  return merged;
}
这段代码里有三个刻意的选择:
整篇插在该文档第一次出现的位置。 比如原结果是 [X#7, 清单#2, Y#0, 清单#0],补全后是 [X#7, 清单#0, 清单#1, 清单#2, Y#0]。其他文档的相对顺序不变,重排的结果被尊重。
文档内部按 chunkIndex 排序,而不是按相关度排序。 清单和流程的阅读顺序本身就是信息。原来命中顺序可能是 #1, #0, #2,补全后统一成 #0, #1, #2, #3, #4,模型看到的就是一篇完整、有序的文档。
原命中片保留原分数,补出来的片用该文档命中片的最低分。 补全片不应该比真正命中的片“更相关”,用最低分可以保证:如果下游还有按分数截断或排序的逻辑,补全片最多和分数最低的命中片并列,不会排到任何真实命中片前面,不会反客为主。
4. 失败降级
export async function expandSiblingChunks(
  sources: SourceHit[],
  fetchDocumentChunks: DocumentChunksFetcher
): Promise<SourceHit[]> {
  const candidates = [
    ...new Set(sources.flatMap(s => documentsToExpand(s.results))),
  ];
  if (candidates.length === 0) return sources;

  let fetched: KbSearchResult[];
  try {
    fetched = await fetchDocumentChunks(candidates);
  } catch (err) {
    logger.warn({ err }, "同文档切片补全失败,降级为原召回");
    return sources;
  }

  const fullChunks = new Map<string, KbSearchResult[]>();
  for (const c of fetched) {
    const list = fullChunks.get(c.documentId) ?? [];
    list.push(c);
    fullChunks.set(c.documentId, list);
  }
  if (fullChunks.size === 0) return sources;

  return sources.map(source =>
    source.results.some(r => fullChunks.has(r.documentId))
      ? { ...source, results: mergeSource(source.results, fullChunks) }
      : source
  );
}
补全是增强,不是主链路。所以:
- 没有候选文档时直接返回原对象,不发查询;
- 查询失败只记日志,返回原召回结果,用户最多拿到和以前一样的回答;
- 候选文档全部超长时,SQL 返回空,同样原样返回;
- 某个知识源本身检索失败或为空,不受影响。
七、用测试把行为钉住
这类逻辑最怕后来有人“顺手优化”掉某个细节,所以每个刻意的选择都有一条对应的测试:
| 测试用例 | 钉住的行为 |
|---|---|
| 同一小文档多片命中时补全全部切片,按 chunkIndex 排序 | 补全生效、文档内按原文顺序、原命中片保留原分数、补全片取最低分 |
| 只命中 1 片的文档不扩展,也不发起查询 | 触发阈值,以及不触发时零额外开销 |
| 取不到全文(文档超出片数上限)时保留原召回 | 长文档不补全 |
| 扩展文档插在其首次命中位置,不打乱其他文档顺序 | 尊重重排结果 |
| 检索失败或空召回的库原样返回 | 不影响失败降级链路 |
| 补全查询失败时降级为原召回 | 增强失败不影响主链路 |
取数函数是注入的,所以这些测试都不需要数据库,跑起来是毫秒级的。
八、效果和边界
回到开头的案例:技术平台这一路命中了模型清单的 3 片,满足“命中 ≥ 2 片”;这篇文档一共 8 片,满足“≤ 10 片”。补全后,8 片按原文顺序全部进入上下文,私有化部署和 SaaS 接入两部分模型都在模型的视野里。
这个方案也有明确的边界:
- 只命中 1 片的清单问题救不了。 如果问题措辞比较特殊,只命中了清单的某一片,补全不会触发。这正是数据层“首片放汇总”仍然有价值的原因,两层是互补的。
- 超过 10 片的长文档不补全。 长文档需要别的手段,比如命中片前后各扩一片的“邻居窗口”,或者给文档打上“原子文档”标签,让某些必须整篇使用的文档无视片数限制。
- 阈值是经验值。 2 和 10 跟我们的切片长度、topK、知识源数量强相关。换一套参数,阈值也要重新估。建议把它们做成可配置项,并记录每次补全触发的文档和片数,用真实日志来校准。
- 上下文会变长。 最坏情况下单路从 3 片变成 10 片。我们的场景是三路各 topK=3、模型上下文足够,这个代价可以接受;如果知识源更多或上下文更紧,需要再加一层全局预算控制。
九、和“双层上下文”是什么关系
之前那篇流程类 RAG 漏步骤给的方案,是在文档级加 summary 和 full_steps,让模型即使只命中局部片段,也能看到完整的流程骨架。
这两个方案解决的是同一个根问题(切片是局部的,用户要的是全局),但适用场景不同:
流程类文档:步骤可以被压缩成骨架 → 用文档级 full_steps 兜住主路径
清单类文档:条目不能被压缩      → 文档小就直接补全整篇切片
长文档细节:只需要局部        → 保持 chunk 级召回
清单之所以不能靠摘要解决,是因为清单的价值就在每一个条目上。把三十个模型名压缩成“支持多种主流文本和多模态模型”,对用户来说等于没答。
十、总结
RAG 的 topK 是一个全局的、粗粒度的预算,它不知道某几片切片其实属于同一个不可分割的整体。清单类问题漏项,本质上是“按片截断”和“按文档使用”之间的错位。
同文档切片补全做的事情很简单:
同一文档多片命中 → 问题聚焦这篇文档
文档足够小      → 整篇给模型
插在原位置      → 不打乱重排
按原文顺序      → 保留清单结构
失败就降级      → 不影响主链路
它不需要重建索引,也不需要全局调大 topK,只在最需要的地方多花一点上下文,换来清单类回答的完整性。
召回对了每一片,不等于把一篇文档完整地交给了模型。
相关阅读
- RAG 为什么回答流程问题会漏步骤? — 文档级摘要和完整步骤的双层上下文方案
- 企业级 RAG 怎么落地? — 知识治理、权限、安全与运营闭环
- RAG 答非所问?从索引到生成,打通最后一公里 — 索引、检索与生成阶段的优化
- 加权 RRF:多通道怎么融、弱匹配怎么降级 — 多路召回为什么用名次融合