第 4 篇把多通道名次融成总榜,并给出相对状态(整体匹配较弱 / 候选集中 / 候选接近)——融合分只用于排序,不伪装成置信度。场景仍与国内 top 纸企「纸品陈列审核 09 月批次」一致:约三百闭集候选、糊截图、人工在 SaaS 里完成最终关联;第一篇写清边界,第二篇为索引预留了确认回流图挂点,第三篇约定各通道有序列表与命中哪张参考图。
本篇只谈人机闭环:检索结果怎样变成可读的候选卡,标注员确认时系统记什么,以及如何把一次正确关联沉淀成下一轮的索引资产。不写侧栏或插件的具体实现,也不自动替 SaaS 提交。
一、候选卡:证据先于名次
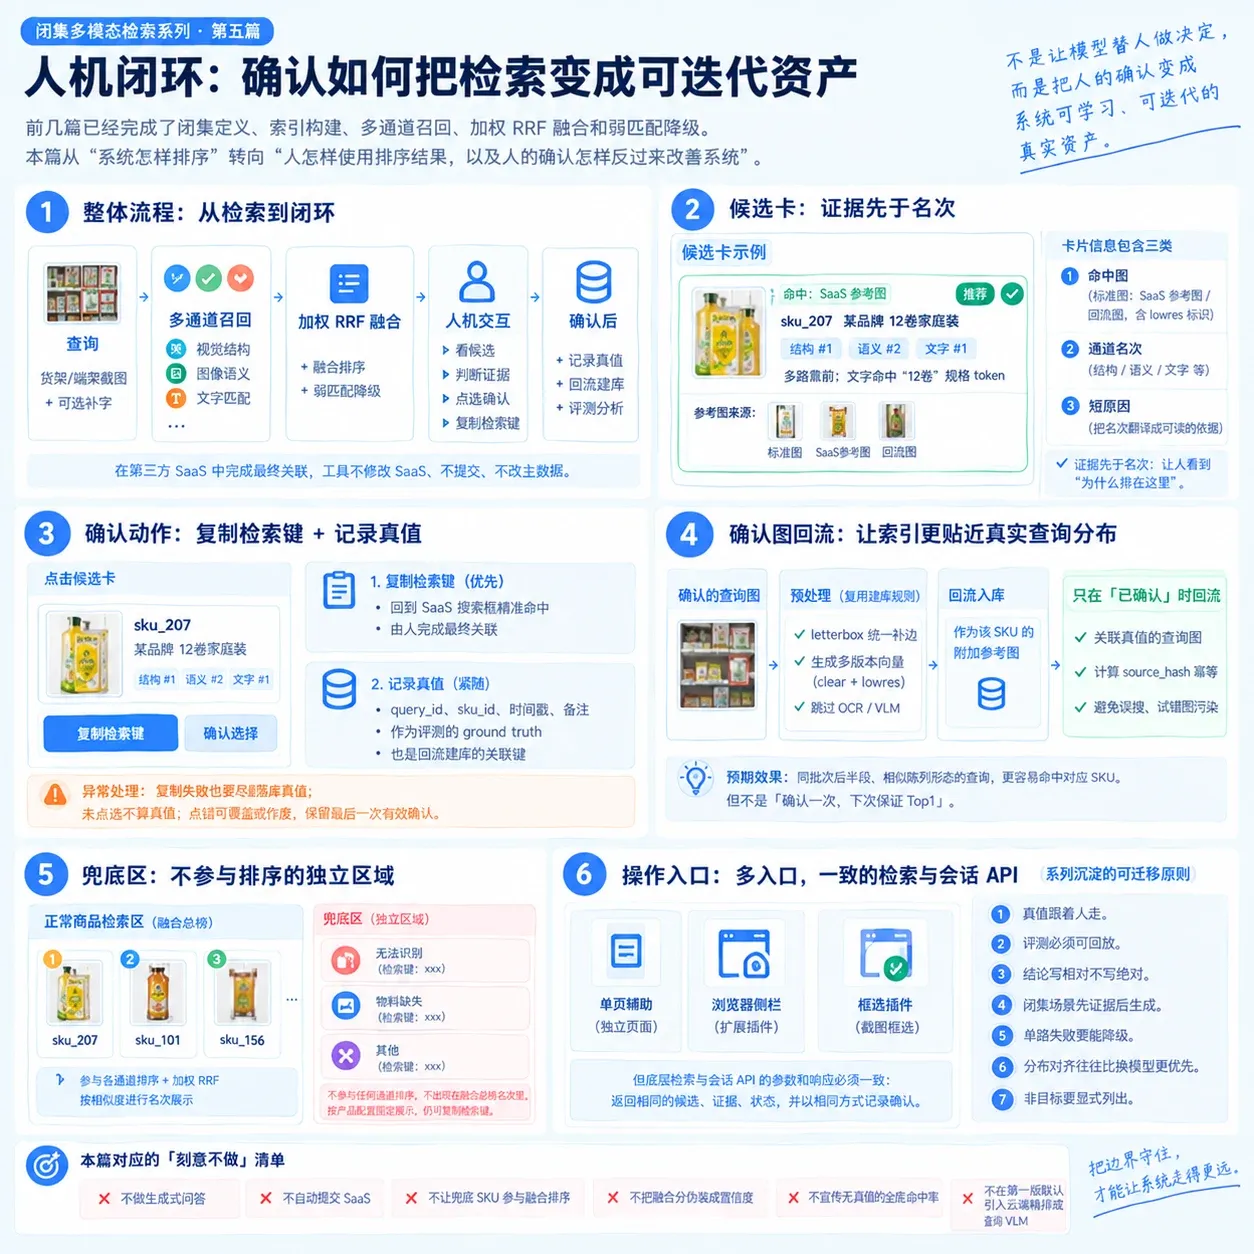
总榜 Top 若干条,每条是一张候选卡。标注员要在几秒内判断「像不像、敢不敢点」,卡上至少需要三块信息,且都来自第 3、4 篇已产出的字段——不另造神秘分数。
| 要素 | 含义 | 展示习惯 |
|---|---|---|
| 命中图 | 该 SKU 在本通道得分最高时,对应哪张参考图(标准图、SaaS 参考图或历史回流图) | 缩略图 + 版本标签(如 lowres) |
| 通道名次 | 各参与通道上的 rank | 如「结构 #1 · 语义 #2 · 文字 #1」 |
| 短原因 | 一句人话,由名次与输入模式拼出 | 不引用融合分数值 |
假数据示例(与系列前文 sku_101、sku_207 对照;用户粘贴端架局部图并补了「12 卷」):
状态提示:候选接近

#1  sku_101
    命中图:ref_lowres_03(该 SKU 的 lowres 参考)
    通道:结构 #1 · 语义 #2 · 文字 #1
    短原因:多路靠前;文字命中规格 token

#2  sku_207
    命中图:ref_clear_01
    通道:结构 #2 · 语义 #1 · 文字 —
短原因:语义路领先;未参与文字路时名次显示为 —若状态为整体匹配较弱,仍列出有限条候选与 per-channel 名次,但语气收敛,避免让人误以为榜首「一定对」。若为候选集中,可在卡片区顶部重复状态文案,帮标注员决定少扫一眼还是多补几个字重搜——仍是相对判断,不承诺命中率。
二、确认:复制检索键 + 记真值
点选某张候选卡,系统做两件事,顺序上复制优先、记录紧随:
- 复制检索键:把该 SKU 在平台侧的检索键写入剪贴板(或等价的一键复制),标注员回到 SaaS 搜索框粘贴,人工完成关联。辅助工具不调用 SaaS 写接口,不自动选中任何表单项。
- 记真值:在同一会话(或同一查询 id)下写入确认记录:
query_id、确认的sku_id、时间戳,以及可选备注。这条记录是后续评测篇的真值来源,也是回流建库的关联键。
未点选就离开、或点错后改选,产品层应允许覆盖或作废上一次确认,但 POC 里至少保证「最后一次有效确认」可追踪。检索键复制失败时,仍应尽量落库真值,避免「人以为确认了、数据却没记下」。
三、确认图回流:飞轮,不是自动写 SaaS
标注员用来检索的那张查询截图(框选结果),在确认后可以异步沉淀为对应 SKU 的附加参考图,进入第二篇所述多参考图池:按 SKU 聚合、检索时多图取 max、并继续记录命中哪一张。
要点:
- 触发时机:与「记真值」绑定,而不是每次搜索都入库——避免误搜、试错的糊图污染索引。
- 预处理:与建库同一套 letterbox;通常跳过 OCR/VLM 建档,价值在视觉分布对齐。
- 幂等:对查询图字节算
source_hash,与标准图相同规则,未变则跳过重算向量。 - 边界:回流只 enrich 本批次闭集内的 SKU 索引,不修改 SaaS 主数据、不代替业务下发标准图。
相对预期:同一批次后半段,与早期查询分布相近的端架局部图,在结构路上更容易命中自己曾确认过的 SKU——这是分布对齐的慢反馈,不是「确认一次就保证下次 Top1」。评测时应用 case 级前后对比,而不是对外宣传固定提升百分点。
四、兜底区:不参与排序、固定可见
批次内除正常候选外,往往还有平台规定的兜底 SKU(无法识别、物料缺失等场景人工选用的条目)。它与闭集商品检索不是同一类问题:
- 不参与各通道排序与加权 RRF,不出现在融合总榜名次里。
- 固定展示在列表下方或独立区域,顺序按产品配置(如平台字段顺序),不随本次查询相似度重排。
- 标注员仍可复制其检索键,但系统不暗示「模型推荐兜底」。
这样与第 4 篇弱匹配提示分工清晰:弱匹配时正常候选仍按融合分排列;兜底区始终是「规则位」,不是「模型排出来的最后一名的替身」。
五、操作面:同一 API,本篇止步于此
单页辅助、浏览器侧栏或框选插件可共用同一套检索与会话 API,参数与响应形态一致即可,具体壳层不在本篇展开。
六、本篇产出与下一篇
人机闭环向系统外留下三类可迭代资产:
- 确认会话与真值标签,供离线评测与 case 复盘;
- 确认回流参考图,让索引更贴真实查询分布;
- 候选卡上的可解释证据(命中图、通道名次、短原因),让人愿意点、也敢质疑。
下一篇 闭集检索评测与「刻意不做」清单 约束:如何用上述真值记 case、如何避免把 POC 指标吹成生产承诺,并与系列非目标表对齐。
本系列
- 闭集多模态检索:为什么不是再做一个 RAG
- 多模态检索建库:分布对齐比换模型更重要
- 多通道召回:每种失败模式配一条检索路径
- 加权 RRF:多通道怎么融、弱匹配怎么降级
- 人机闭环:确认如何把检索变成可迭代资产
- 闭集检索评测与「刻意不做」清单