第 3 篇把契约定死了:每个 RecallChannel 只在当前批次闭集里排序,返回降序的 list[id]——不负责跨通道算最终名次。输入模式决定哪些通道为空(仅图关文字路、仅文关视觉路),多参考图在 SKU 内取 max 并记下命中图,证据留给展示层。
本篇接在「通道 → 有序列表」之后,回答两件事:怎么融成一张总榜,以及榜很虚时怎么提示标注员,而不是伪造一个看起来很科学的百分比。场景仍与第一篇一致:纸品陈列审核 09 月批次约三百候选、糊截图、复制检索键回 SaaS;建库与分布对齐见第二篇。不写插件侧栏细节,也不承诺任何绝对命中率。
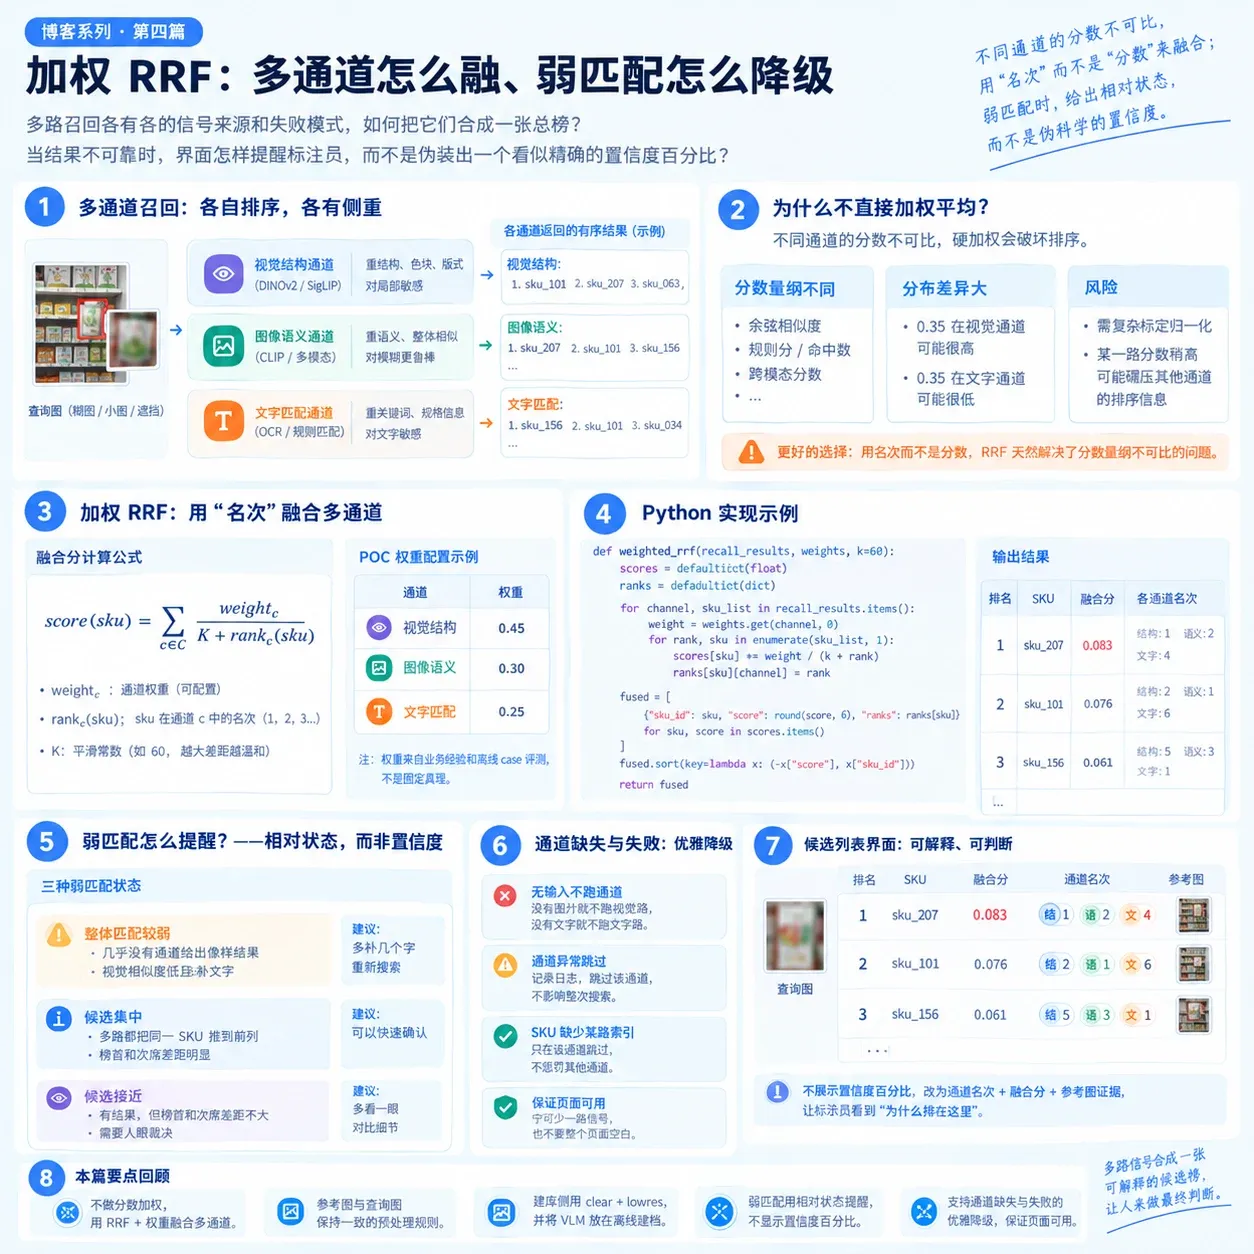
一、为什么不用「把相似度加权平均」
各通道的原始分往往量纲不同、标度不同:
| 通道 | 典型原始分 | 直接相加的问题 |
|---|---|---|
| V1 视觉结构(DINOv2) | 余弦相似度,分布依特征与归一化方式而定 | 与 T2 字符匹配的整数分不在同一尺度 |
| V2 图像语义(SigLIP) | 余弦相似度 | 两路视觉分的「0.35」是否同等可信,依赖查询图质量 |
| T2 字符与别名 | 规则分、命中片段数 | 分母、上限与向量分无关 |
| T1 文字→图 | 跨模态余弦 | 用户只打两个字时,分布与长句不同 |
若在 POC 里硬做 α·sim_v1 + β·sim_v2 + …,很快陷入两件事:一是要为每路单独做标定或归一化,调参成本随通道数上升;二是某路分数略高就会碾压其它路的排序信息,违背第 3 篇「每种失败模式配一条通路」的初衷。
Reciprocal Rank Fusion(RRF) 换了一个问题:不问「第 5 名比第 6 名强多少分」,只问「在第 k 名时,各通道愿意给它多少贡献」。贡献随名次单调递减,且不同通道只通过名次对话,原始相似度不必拉到同一标尺。闭集三百条、每路只取 Top 几十时,这种融合足够稳、也够好解释。
二、加权 RRF:名次贡献与 K
对通道 c 上排在第 r 名的 SKU,贡献约为 weight_c / (K + r)。K 是平滑常数:越大,前几名之间的分差越温和;POC 里常用一个固定 K(例如 30)配合离线评测微调,不在正文里把某个 K 写成生产承诺。
多条通道对同一 SKU 的贡献相加,得到融合分;再按融合分降序出总榜。并列时可用 SKU id 作稳定次序键,避免同一查询两次刷新名次乱跳。
同品类闭集里,糊截图往往仍能从包装布局、刀版图块里抠出结构线索——因此工程上常让视觉结构通道在融合里相对更重,图义通道作补充,文字路在用户有输入时保持可听见的音量。注意:这是相对偏置,不是「结构路永远比语义路准 x%」。权重应来自配置与评测迭代,下面仅作示例配置说明形态(数值勿当对外 SLA):
# 示例配置(POC 调参用,非承诺值)
vision_structure  → 1.8
vision_semantic   → 0.7
text_token        → 1.0   # 文字相关通道可同权
调权顺序仍建议与系列前文一致:先确认 letterbox、lowres 与多参考图覆盖率 → 再查通道是否被输入模式误关 → 最后再动权重表。某次评测里把结构路从 1.0 调到 1.8 后 Top 列表「更符合肉眼」时,记录的是相对改善与 case 集,而不是对外宣传「提升 12% 命中」。
三、从第 3 篇的列表到融合:完整片段
下列代码与 POC 精神对齐:输入是「通道名 → 有序 sku_id 列表」,输出带每路名次与融合分。SKU 用字符串假 id,便于和系列前文 sku_101、sku_207 对照。
from dataclasses import dataclass

@dataclass
class FusedItem:
    sku_id: str
    score: float
    ranks: dict[str, int]

def rrf_fuse(
    rankings: dict[str, list[str]],
    k: int = 30,
    weights: dict[str, float] | None = None,
) -> list[FusedItem]:
    scores: dict[str, float] = {}
    ranks: dict[str, dict[str, int]] = {}
    for channel, ordered in rankings.items():
        if not ordered:
            continue
        weight = 1.0 if not weights else weights.get(channel, 1.0)
        for rank, sku_id in enumerate(ordered, start=1):
            scores[sku_id] = scores.get(sku_id, 0.0) + weight / (k + rank)
            ranks.setdefault(sku_id, {})[channel] = rank
    fused = [
        FusedItem(sku_id=i, score=round(s, 6), ranks=ranks[i])
        for i, s in scores.items()
    ]
    fused.sort(key=lambda x: (-x.score, x.sku_id))
    return fused
示例输入(通道名可映射到第 3 篇的 V1/V2/T2;某路失败则不要放进 rankings):
rankings = {
    "vision_structure": ["sku_101", "sku_207", "sku_303"],
    "vision_semantic": ["sku_207", "sku_101"],
    "text_token": ["sku_101"],
}
# 某通道失败时直接不出现在 rankings 中即可对这份假数据,若采用上一节的示例配置权重,sku_101 在结构路与文字路都靠前、语义路也不差,通常会坐上融合榜首;sku_207 在语义路夺魁、结构路次席,是「多路共识但领先不尖锐」的典型;sku_303 只出现在结构路中游,总榜会靠后——这正是 RRF 想要的「多路投票」,而不是单路分数一家独大。
展示层仍可把 FusedItem.ranks 译成人类可读一句(例如「结构 #1 · 语义 #2 · 文字 #1」),但不要把 score 改成 0~100% 的「置信度」:融合分是秩贡献之和,对标注员没有概率语义,对内调参才有排序意义。
可选:与实现对照(脱敏)
若你在自己的仓库里已有同类函数,形态通常就是「遍历通道 → 空列表跳过 → 累加 weight/(k+rank)」。下面是与上文等价的伪代码轮廓(类型与通道名已脱敏,仅作对照阅读):
def build_rrf_weights(*, v1=1.8, v2=0.7, other=1.0) -> dict[str, float]:
    """同品类闭集下偏视觉结构,文字通道保持等权 — 数值均为示例配置。"""
    ...
生产代码里 sku_id 可能是整数主键、通道键可能是 v1/v2/t2;系列正文统一用假字符串 id,避免和某一仓库绑定。
四、弱匹配:相对状态,不装成置信度
闭集检索的交付物是「缩小范围 + 证据」,不是「模型断定就是这条」。当糊图导致各路都虚、或榜首与次席在融合分上咬得很近时,UI 更适合给相对状态提示,帮标注员决定是快速点选还是多扫一眼、是否补几个字重搜。
POC 里一类可落地的规则(语义示意,阈值随评测改):
| 状态文案 | 何时出现(直觉) |
|---|---|
| 整体匹配较弱 | 几乎无路有像样命中,或视觉最强相似度仍很低且用户也没给文字 |
| 候选集中 | 多路都把同一 SKU 顶在前列,且融合榜首相对次席拉开一段 |
| 候选接近 | 有结果,但榜首与次席融合分差距不大,需要人眼裁决 |
这些状态不是分类器 softmax,也不该展示「87% 匹配」。标注员在 SaaS 里承担最终关联责任;辅助页只说「这次检索信不信任自己」——弱时宁可语气收敛,也不要用假精确度换表面专业感。
弱匹配时仍列出 Top 若干与 per-channel 名次,让人能看见「哪一路在硬撑」;若与兜底 SKU 展示区分,应在产品层固定规则(系列第 5、6 篇会接人机闭环与评测),本篇不展开 UI 组件。
五、通道缺失、失败与空列表:跳过,不惩罚整次搜索
第 3 篇已约定:无输入则该通道返回空列表。融合层遵守同一哲学:
- 空列表:
rrf_fuse里if not ordered: continue,该通道贡献为零,不拉低其它路,也不把「未参与」当成负分。 - 编码或检索异常:单通道 try/except 后记日志,该通道不出现在
rankings里——等价于本次搜索少了一票,而不是整次 500。 - 仅图 / 仅文:未启用的通道根本不调用
rank,rankings键集合变短,融合仍照常进行。 - 某 SKU 缺某路索引:在通道内部跳过该条特征即可;若该路仍对其余 SKU 出榜,融合只使用参与了的 SKU 名次。
这与 POC「单通道失败时降级继续搜」一致:标注员在赶批次时,宁可少一路信号,也不要整页空白。事件日志里可记下当时有哪些通道键、权重表与 state_hint,供离线复盘,但不要求本篇展开表结构。
六、融合之后交给谁
本篇产出两样东西,供后续文章消费:
- 融合分 + 每通道名次(
FusedItem语义),用于排序与「为什么在这里」的简短理由; - 相对状态提示(整体弱 / 候选集中 / 候选接近),用于弱匹配降级话术。
下一篇 人机闭环 会写:标注员确认后如何把查询截图变成回流参考图,让第 2 篇的索引越用越贴查询分布;评测与非目标 则约束怎么记 case、怎么避免把 POC 吹成生产指标。
本系列
- 闭集多模态检索:为什么不是再做一个 RAG
- 多模态检索建库:分布对齐比换模型更重要
- 多通道召回:每种失败模式配一条检索路径
- 加权 RRF:多通道怎么融、弱匹配怎么降级
- 人机闭环:确认如何把检索变成可迭代资产
- 闭集检索评测与「刻意不做」清单